Ce que le règlement européen dit vraiment. Et ce qui reste flou.
L’AI Act est entré en vigueur en août 2024. Depuis, deux camps s’affrontent : ceux qui y voient une catastrophe réglementaire pour l’innovation européenne, et ceux qui le balaient d’un revers de main.
Les deux se trompent.
La plupart des entreprises ne sont concernées que par des obligations légères. Celles qui déploient de l’IA dans des contextes sensibles ont des échéances réelles qui approchent. Et quelques zones grises dans le texte lui-même ne seront réglées que par la jurisprudence.
J’ai eu la même conversation une douzaine de fois depuis un an. Quelqu’un qui travaille dans la tech, qui a croisé le terme « AI Act » dans une newsletter ou lors d’un board meeting, me demande si son équipe devrait s’en préoccuper.
La réponse honnête tient en une phrase : probablement pas beaucoup, sauf si vous travaillez sur des outils RH, de crédit ou de santé.
Voici le résumé de l’AI Act pour ceux qui ne l’ont pas lu, et ne souhaite pas le lire.
Avertissement de bon sens : je ne suis pas juriste. Ce qui suit est la lecture d’un praticien IA qui a passé du temps sur le texte original, pas l’avis d’un avocat spécialisé. Pour des décisions de conformité réelles, c’est un autre métier.
1. Ce que le règlement fait réellement
L’erreur de lecture la plus fréquente : croire que l’AI Act réglemente l’IA.
Il ne réglemente pas l’IA. Il réglemente certains usages de l’IA dans des contextes à risque élevé.
Cette distinction change tout. Le texte ne contient pas de liste de modèles interdits, pas de liste de technologies prohibées. Ce qu’il contient, c’est une classification des usages par niveau de risque. Et la majorité des usages IA courants (assistants de rédaction, outils de recommandation, filtres anti-spam, chatbots internes) tombent dans la catégorie « risque minimal ». Aucune obligation spécifique.
L’exemple à retenir : si vous prenez GPT-5 et que vous l’utilisez pour aider votre équipe commerciale à rédiger des emails, vous êtes en risque minimal. Si vous utilisez le même modèle pour trier automatiquement des candidatures et décider qui passe en entretien, vous êtes en haut risque. Même couche LLM. Mais une réglementation radicalement différente.
Le règlement classe par usage et par contexte, pas par technologie.
2. Les quatre niveaux, sans jargon
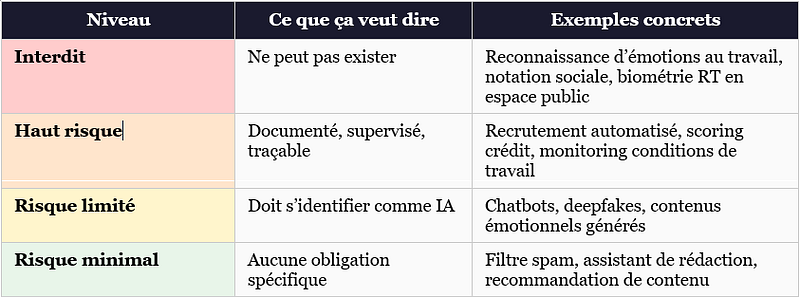
Interdit. Aucune mise sur le marché ni déploiement possible. Un système déjà en production doit être retiré.
Haut risque. Le régime lourd : évaluation de conformité, documentation technique, données tracées, supervision humaine, journalisation et enregistrement dans la base européenne avant la mise sur le marché. Le fournisseur porte l’essentiel de la charge, le déployeur garde la supervision et la tenue des logs.
Risque limité. Une seule obligation, de transparence : signaler à l’utilisateur qu’il parle à une IA et marquer les contenus générés ou manipulés.
Risque minimal. Aucune obligation contraignante. Le règlement encourage seulement l’adhésion volontaire à des codes de conduite.
La majorité des équipes tech vivent dans les deux dernières lignes.
3. La timeline — ce qui est déjà derrière nous
La timeline complète s’étend jusqu’à 2027, ce qui crée une illusion de marge. Plusieurs jalons sont pourtant déjà dépassés.
Février 2025 : les interdictions entrent en vigueur. Si vous avez déployé un outil de reconnaissance d’émotions en réunion ou d’analyse affective des salariés, la question se pose maintenant.
Août 2025 : les règles s’appliquent aux fournisseurs de modèles de fondation, ce que le règlement appelle les GPAI (General Purpose AI), soit les modèles entraînés à grande échelle pour accomplir des tâches multiples. OpenAI, Google, Mistral, Anthropic. Ils ont des obligations de transparence sur les données d’entraînement et les capacités de leurs modèles. Pour les entreprises qui utilisent ces APIs, l’impact direct est limité. Mais ça crée une traçabilité dans la chaîne de responsabilité.
Août 2026 : la deadline principale pour les systèmes à haut risque Annexe III (voir paragraphe suivant). C’est dans un mois.
4. L’Annexe III — qui est vraiment dans le collimateur
L’Annexe III liste huit domaines à haut risque. Quatre concernent directement les entreprises qui m’appellent.
Infrastructures critiques. Le règlement vise les systèmes d’IA utilisés comme composant de sécurité dans la gestion des infrastructures numériques critiques : supervision d’un réseau télécom, orchestration d’un datacenter, pilotage de la continuité de service. Un acteur qui opère ce type d’infrastructure pour des clients européens entre dans le périmètre.
Emploi et gestion des ressources humaines. C’est le domaine le plus directement concerné pour beaucoup. Sont explicitement listés : les systèmes de recrutement automatisé (tri de CV, scoring candidats), l’évaluation de la performance des salariés, les outils qui assistent les décisions de promotion ou de licenciement, la surveillance de l’activité au travail. Et, point qui génère beaucoup d’ambiguïté, « le contrôle et l’évaluation des conditions de travail ».
Accès aux services essentiels. C’est là que le secteur bancaire et l’assurance sont concernés. Trois exemples : l’évaluation de la solvabilité et le scoring de crédit des particuliers (la détection de fraude reste, elle, hors périmètre), la tarification et l’évaluation du risque en assurance vie et santé, l’instruction des demandes de prestations sociales.
Santé. Dispositifs médicaux avec composante IA, aide au diagnostic.
Trois autres domaines complètent la liste : la répression, la gestion des migrations, l’administration de la justice. Ils relèvent d’acteurs publics et ne concernent pas les entreprises dont je parle ici.
Un mot sur l’AI Omnibus : un accord provisoire signé le 7 mai 2026 apporte plusieurs changements substantiels. Deux nouvelles interdictions seraient ajoutées à l’article 5, effectives dès décembre 2026 : les deepfakes intimes non-consentis et la génération de contenu pédopornographique. Ce texte n’est pas encore formellement adopté, mais ces deux interdictions sont plutôt une bonne chose.
5. Ce que le texte lui-même ne tranche pas
C’est ici que les synthèses s’arrêtent. Et là que commencent les vraies questions opérationnelles. Reprenons quelques-uns des usages décrits plus haut.
Le contrôle des conditions de travail. L’Annexe III vise les systèmes qui évaluent la performance et le comportement des salariés. Mais un outil qui mesure la charge d’une équipe à partir de données agrégées, sans aucune décision automatisée sur une personne, et dont chaque collaborateur peut consulter ses propres données, entre-t-il dans cette catégorie ? Le texte ne le dit pas. L’entreprise qui déploie cet outil doit pouvoir justifier sa classification, et l’inscrire dans sa documentation technique avant le déploiement, pas le jour où un DRH client pose la question lors d’une due diligence.
La solvabilité et la fraude. Le scoring de crédit est explicitement à haut risque, mais la détection de fraude financière en est exclue. Or beaucoup d’outils bancaires font les deux avec le même moteur : un seul modèle évalue un risque de défaut et signale une transaction suspecte. La frontière devient difficile à tracer quand les deux fonctions partagent la même architecture. Le règlement ne tranche pas, et c’est l’entreprise qui devra documenter où elle place la limite.
La reconnaissance d’émotions. L’interdiction de février 2025 couvre l’inférence d’émotions à partir de données biométriques. Analyser le sentiment dans un texte écrit reste probablement autorisé. Analyser le ton et le rythme de la voix pendant une réunion ne l’est probablement pas, car la voix est une donnée biométrique comportementale. La zone réellement ouverte concerne les outils hybrides, qui croisent l’analyse du texte et celle de la voix : aucune décision ne permet encore de savoir comment ils seront classés.
L’application aux acteurs non-européens. Un éditeur américain qui vend un outil de scoring de crédit à une banque européenne tombe dans le champ du règlement. Le mécanisme existe sur le papier. Mais aucune sanction n’a encore visé un fournisseur hors UE, et personne ne sait à quelle vitesse la première tombera.
Pour conclure sans conclure
L’AI Act est un règlement gradué. Pour la majorité des équipes qui lisent cet article, l’impact quotidien est limité aux chatbots qui doivent s’identifier. Pour ceux qui construisent de l’IA dans les RH, la finance ou la santé, les obligations sont réelles et les délais proches.
Ce que le texte ne résout pas encore, la jurisprudence le résoudra. La décision pratique en attendant : documenter maintenant les choix d’architecture et les arguments de classification. Pas une fois que la ligne a été tracée par un juge ou qu’un client a posé la question lors d’un processus achat.
Lire le texte source reste la meilleure assurance.
Il est moins long qu’on ne le dit.
Sources
artificialintelligenceact.eu• Texte officiel et articles commentésai-act-service-desk.ec.europa.eu• Timeline officielle Commission EuropéenneGuidelines on Prohibited AI Practices (C(2025) 5052)• Commission Européenne, juillet 2025EU AI Act Omnibus Agreement — Gibson Dunn• Analyse du Digital Omnibus, mai 2026