Deux mois de construction, une grille d’évaluation des second brain, et beaucoup d’apprentissages pour démêler l’artifice de l’utile.
Le second brain est une pratique vieille de quatre-vingts ans, à laquelle on a collé un nom il y a dix, et qui est redevenue à la mode ces derniers mois. On ne compte plus les publications qui vantent ses mérites, comparent les outils ou livrent la dernière astuce d’organisation. Toutes montrent comment faire. Aucune ne dit ce que cela permet de faire. Alors j’ai pris le problème dans l’autre sens : écrire d’abord la grille d’évaluation de leurs capacités, et ensuite construire mon propre second brain. Ça m’a pris une centaine d’heures cet été. Je vous raconte mon parcours, et je vous donne de quoi construire le vôtre, sans marketing.
Dans cet article nous verrons :
- D’où vient le concept de second brain ?
- Ce que la technologie a débloqué, et ce qu’est un second brain en 2026
- Pourquoi j’ai commencé par écrire une grille
- La grille d’évaluation
- Par où commencer, si vous voulez en construire un
- Mon set up, et ce qu’il permet
- Et maintenant, on fait quoi de tout ça ?
Juin 2026. Pour la troisième fois de la semaine, je tombe sur l’expression « second brain », employée par trois personnes qui n’en donnent pas la même définition.
Pour la première, c’est un dossier bien rangé. Pour la deuxième, une intelligence artificielle qui se souvient de tout. Pour la troisième, une méthode qu’on achète via sa formation, avec des modules et un certificat.
Mais elles ont toutes les 3 en commun la promesse de faire gagner en temps et en qualité.
Avec tous les défis qui arrivent à la rentrée, construire un second brain m’a semblé un bon devoir de vacances et il a largement débordé du temps initialement prévu pendant la sieste de mes enfants.
Alors, c’est parti, construisons notre second brain.
Mais avant de démarrer, qu’est-ce que c’est ?
1. D’où vient le second brain ?
De manière très basique, les second brains ont démarré comme des systèmes d’archivage, pour que leurs auteurs puissent toujours retrouver ce qu’ils ont écrit ou pensé. Trois personnes ont posé les trois premières briques du concept, mais chacune butait sur les technologies de son époque.
Créer des liens organiques entre les sujets
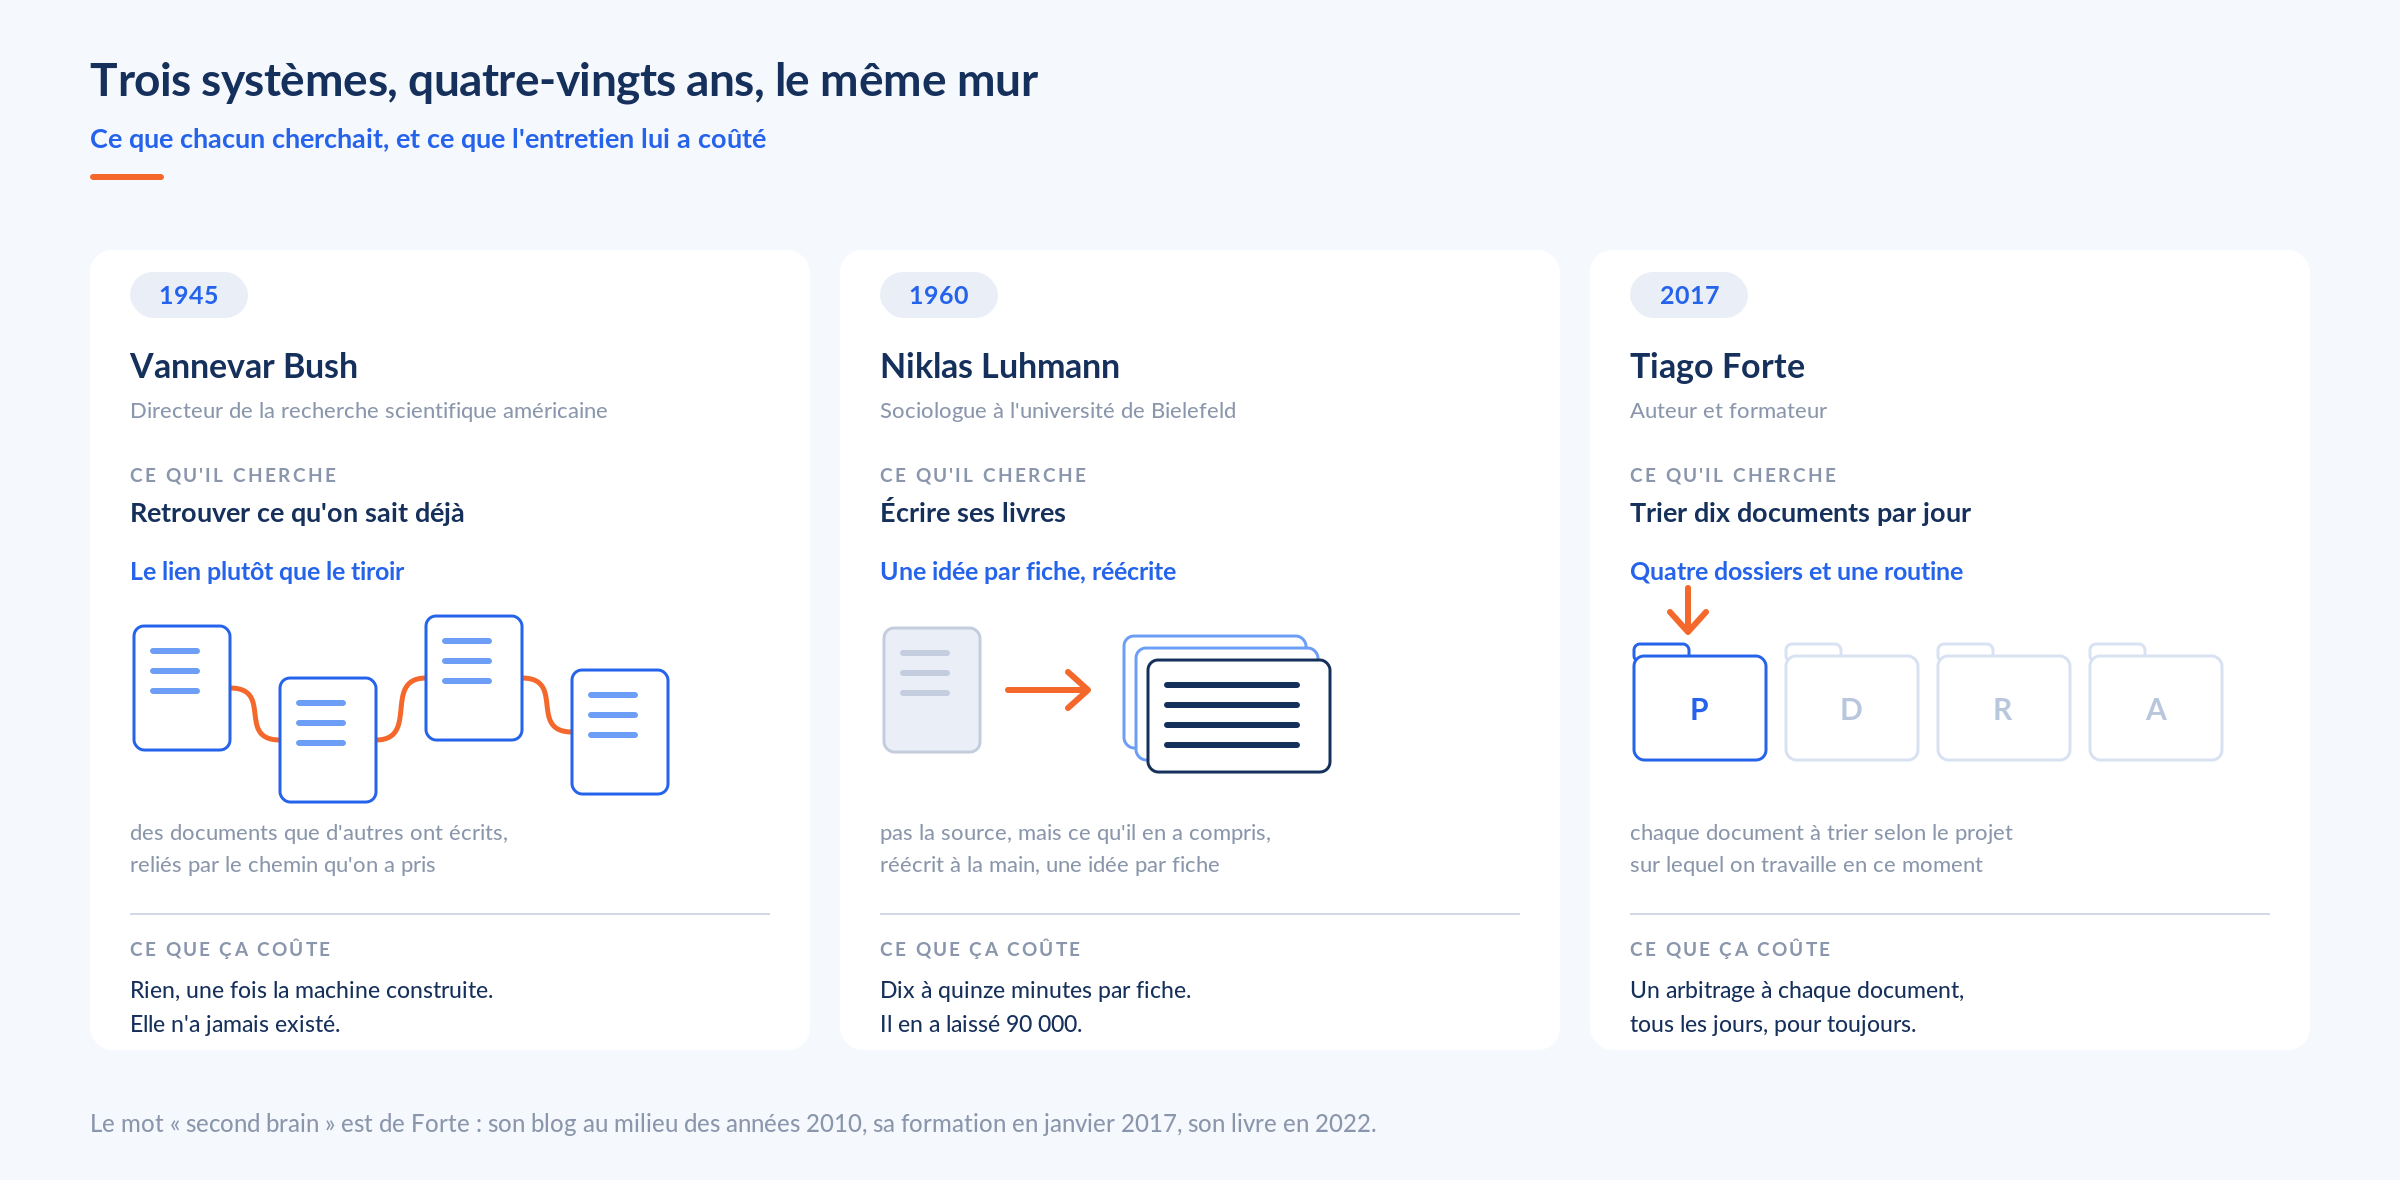
Vannevar Bush dirigeait l’effort de recherche scientifique américain pendant la guerre. Son problème est celui d’un homme qui a piloté des milliers de chercheurs : la science publie plus que ce qu’on peut en lire, et le classement habituel par tiroirs rend introuvable ce qu’on sait déjà. Son objectif tient donc en un verbe, retrouver. En juillet 1945, il décrit dans The Atlantic une machine qu’il appelle le Memex. On y relie deux documents en tapant un code, et à partir de là les deux pages s’appellent l’une l’autre pour toujours. Et avec le temps, on se retrouve avec des files entières de documents qui se suivent, parce qu’ils sont connectés entre eux.
Reformuler les idées, pour les faire siennes
Niklas Luhmann va un cran plus loin, avec un tout autre objectif. Il ne cherche pas à retrouver, il cherche à écrire. Sa boîte à fiches est l’atelier où il fabrique ses livres, et il en parle comme d’un partenaire de travail. Il était sociologue à Bielefeld, et il a laissé environ 90 000 fiches de papier au format d’une carte postale. Là où Bush reliait des documents que d’autres avaient écrits, Luhmann, lui, ne gardait jamais la source : il gardait ce qu’il en avait compris. C’est-à-dire qu’il réécrivait chaque fiche avec ses mots, en phrases complètes. Elle était ensuite glissée derrière la fiche à laquelle elle répondait, tout comme Bush.
Et c’est la réécriture qui fait tout le travail : en reformulant, il s’appropriait l’idée au lieu de simplement l’archiver. Une fiche relue dix ans plus tard lui revenait immédiatement en mémoire, parce que l’effort de compréhension avait été fait au moment de l’écriture. Sauf que c’est là que ça se corse, il estimait dix à quinze minutes de réécriture par fiche. 90 000 fiches. C’était un travail colossal pour construire et maintenir son second brain.
Catégoriser et classer, avec des routines
Tiago Forte n’a ni le problème de Bush ni celui de Luhmann. Le sien est un problème d’arbitrage quotidien : il doit traiter dix documents chaque jour, et il doit décider lesquels sont importants sans y passer sa vie. Il introduisit pour la première fois le concept de second brain pour décrire son dispositif sur son blog au milieu des années 2010, et lance en janvier 2017 la première session de sa formation Building a Second Brain.
Dans son livre de 2022, sa méthode tient en quatre dossiers : Projets, Domaines, Ressources, Archives. À ces dossiers s’ajoute une routine en quatre temps, qu’il résume par l’acronyme CODE : capturer ce qui vous a marqué, l’organiser dans le projet auquel ça servira, le distiller en surlignant un peu plus à chaque relecture jusqu’à ne garder que l’essentiel, puis s’en servir pour produire quelque chose.
Mais de son propre aveu, ce type de système finit souvent par s’écrouler : « if your organizational system is as complex as your life, then the demands of maintaining it will end up robbing you of the time and energy you need to live that life ».
Soyons réaliste, le plus probable est que vous n’ayez jamais entendu parler de ces trois systèmes. C’était mon cas il y a quelques semaines. Pourquoi ? Pour deux raisons très simples.
- la valeur vient de la reformulation et du lien manuel, jamais du stockage. -> ce qui exclut Bush
- et ce travail-là demande plus d’effort qu’il n’en fait économiser. -> ce qui exclut Luhmann et Forte
2. Qu’est-ce que la technologie a débloqué ?
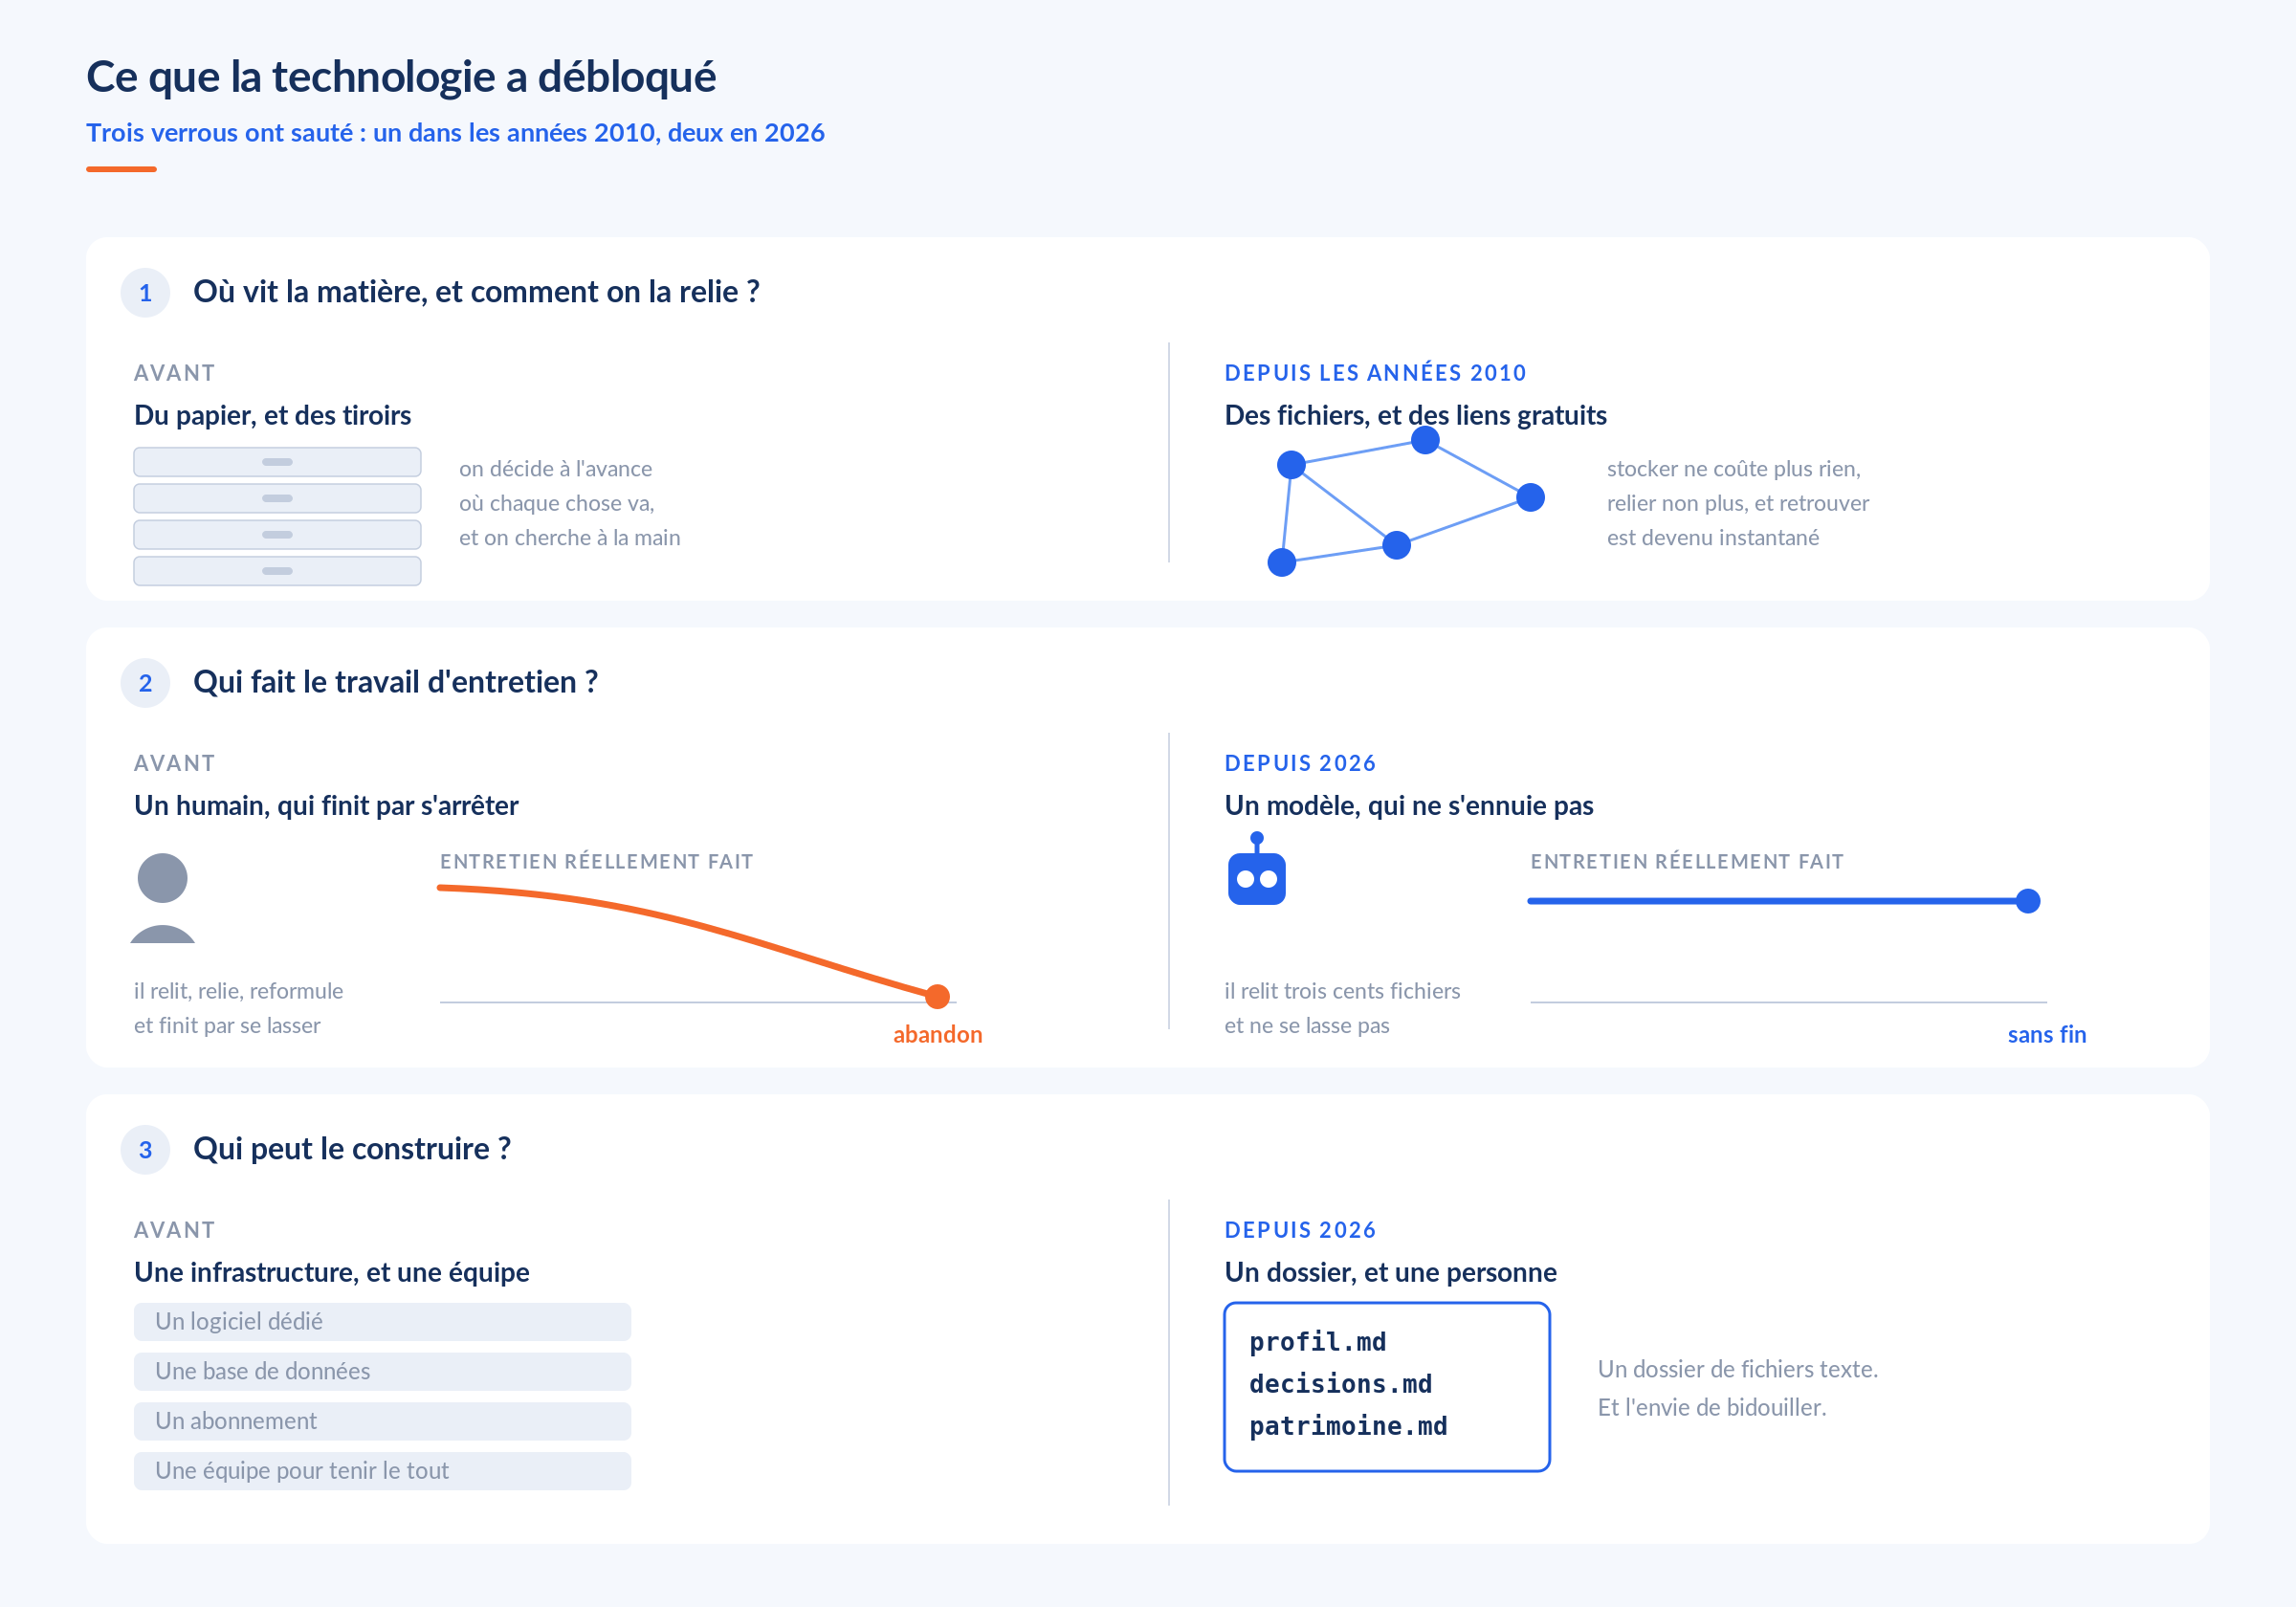
Trois verrous ont sauté, un premier dans les années 2010 et les deux suivants quasiment en même temps, au début de l’année 2026.
Le premier : le stockage et les liens sont digitalisés et simplifiés
Fini les feuilles de papier et les tiroirs à n’en plus finir. Evernote ouvre son service en ligne en 2008 avec une promesse tenue en deux mots : tout retenir. Roam Research en 2019, puis Obsidian en 2020, rendent le lien entre deux notes gratuit et permettent la construction de graphes explorables. Stocker ne coûte donc plus rien. Relier non plus. Chercher et retrouver du contenu sont devenus instantanés.
Le deuxième : les modèles LLM savent désormais lire et écrire les fichiers eux-mêmes
Jusque-là on leur donnait un texte, ils rendaient un texte, et c’était à nous de le ranger au bon endroit. Aujourd’hui on leur donne un dossier, et ils peuvent l’organiser et travailler dedans en toute autonomie. Ils font justement le travail que personne ne faisait : relire trois cents fichiers pour les reformuler, les mettre à jour et y chercher une contradiction, le tout sans aucun effort et sans se lasser au bout de six mois.
Le troisième : il n’y a plus besoin d’être développeur
Pendant vingt ans, construire ces systèmes supposait un logiciel dédié, souvent une base de données, et une infrastructure coûteuse. Depuis le début de 2026, des outils grand public le font sans avoir besoin d’une ligne de code : les espaces de projet de Claude, Hermes dans le téléphone, OpenClaw qu’on héberge sur sa propre machine.
Au-delà de leurs différences, ces systèmes ont un point commun : la matière reste des fichiers texte dans un dossier, lisibles par l’utilisateur. Pas de format propriétaire, rien à exporter le jour où on change d’outil.
Ce qui demandait une équipe demande aujourd’hui un dossier, l’envie de bidouiller, et presque rien d’autre. C’est pour cela que le sujet remonte autant depuis 6 mois.
Alors qu’est-ce que c’est, un second brain en 2026 ?
Au niveau le plus basique, c’est un endroit hors de la tête de son propriétaire où ce qu’il pense est écrit, relié aux concepts concernés, et retrouvable par quelqu’un d’autre que lui. Et a fortiori par une machine qu’il peut interroger.
Un assistant conscient et autonome tel que Jarvis est un second brain, mais de simples fichiers textes avec des automatisations sont aussi un second brain.
Par exemple, Andrej Karpathy, ancien directeur IA chez Tesla, a publié le 4 avril 2026 le code qui fait tourner un tel système. Il le décompose en 3 couches :
- les sources brutes, qu’on ne modifie jamais ;
- des fiches en texte simple que le modèle tient à jour ;
- une fiche de règles qui dit comment tout cela s’écrit.
Et trois actions que le modèle exécute.
- Ingérer : une source arrive, dix à quinze fiches sont mises à jour.
- Interroger : on pose sa question aux fiches, pas aux sources.
- Relire : le modèle repasse sur l’ensemble et signale les contradictions, les affirmations périmées, les fiches orphelines.
Dans son cas, un second brain, c’est un peu de code qui s’exécute, et des fichiers textes.
Tout n’est qu’une affaire de degré d’implémentation. Et c’est ce degré que la suite de cet article va mesurer.
3. Pourquoi j’ai commencé par écrire une grille
Maintenant que nous avons un début de définition, et quelques grandes pistes en termes d’usage, il faut décider à quoi mon second brain va ressembler.
Sachant qu’il existe des dizaines d’implémentations de second brain…
Un template Notion à quatre bases liées. Un coffre Obsidian avec ses liens, son graphe et ses plugins. Le llm-wiki de Karpathy avec deux cents lignes de code. Des dépôts GitHub qui branchent un agent sur un dossier. Des graphes d’agents et de sous-agents. Chacun montre un comment. Aucun ne dit ce que le résultat est censé produire.
Sur quel critère choisir l’un ou l’autre ? Comment concilier ces différentes implémentations ? Surtout que chaque système est la conséquence des contraintes et des besoins de son créateur. Et qu’il aura donc, par nature, des caractéristiques qui ne me correspondront pas.
J’ai alors décidé de prendre le problème dans l’autre sens. Plutôt que de chercher ce qu’il faut construire, définir d’abord ce que ce système doit produire. Et en fonction de ce qui fera du sens pour moi, construire ou non les outils nécessaires.
La question n’est donc pas de savoir quels modules implémenter. Elle est : qu’est-ce que je peux faire aujourd’hui avec ce système que je ne pouvais pas faire hier.
4. La grille d’évaluation du second brain
Construire la grille a été plus complexe qu’anticipé, car dans les brainstormings, Claude a l’immense avantage d’avoir une très forte capacité de raisonnement, mais il oublie parfois que nous les humains n’avons pas tous 160 de QI avec une fenêtre de contexte parfaite de millions de tokens.
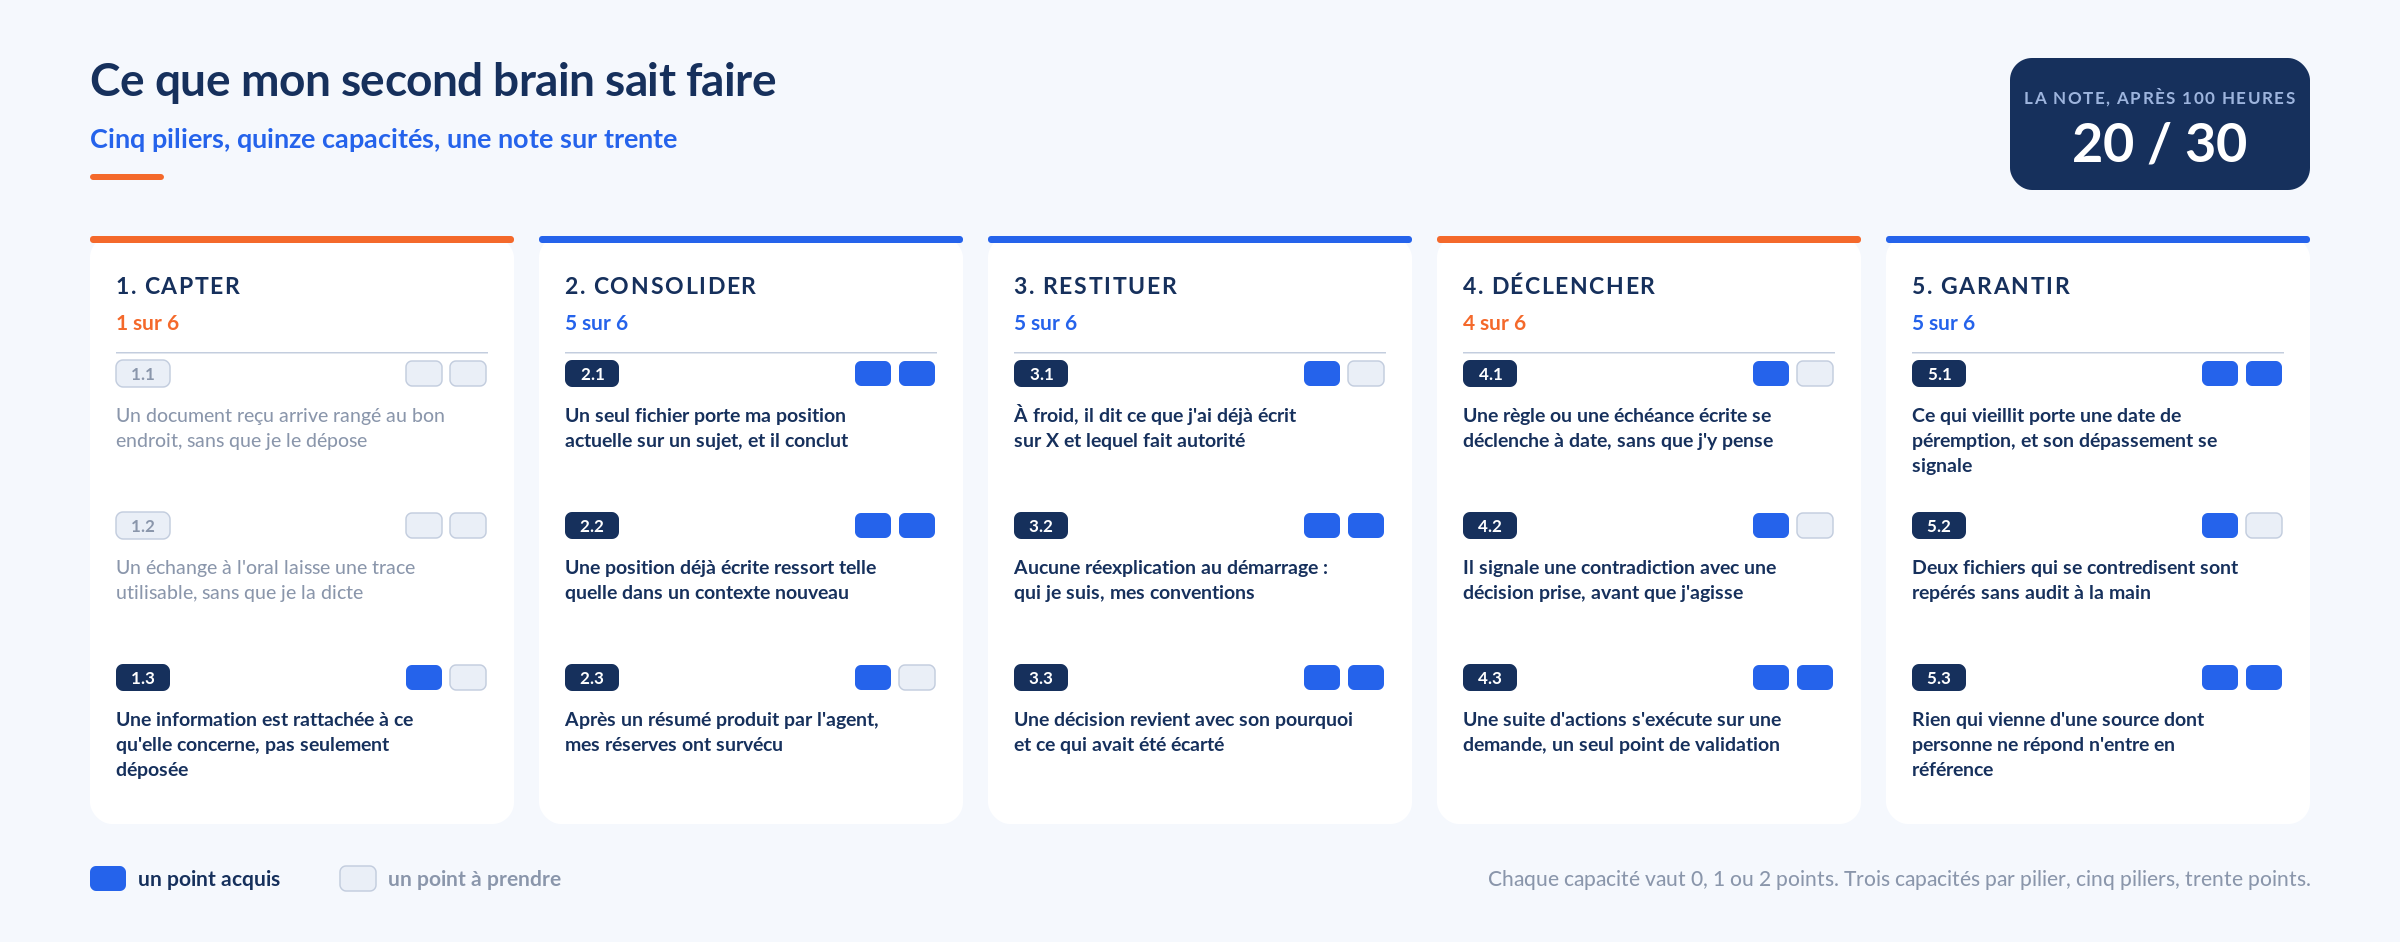
Après plusieurs itérations et simplifications, je suis arrivé aux 5 piliers suivants :
1. Capter : sans que j’y pense, le système doit réussir à capter de l’information.
Par exemple : un document reçu par un canal habituel se retrouve rangé au bon endroit et utilisable, sans que je le dépose moi-même.
2. Consolider : les éléments ajoutés doivent s’organiser et enrichir des éléments existants.
Par exemple : sur un sujet où j’ai réfléchi plusieurs fois, un seul fichier contient ce que je pense actuellement, et il est capable de conclure.
3. Restituer : le système doit pouvoir ensuite produire de l’information de manière déterministe.
Par exemple : à froid, sans que j’indique aucun fichier, il répond « voici ce que tu as déjà écrit sur X », et ce qu’il dit fait autorité.
4. Déclencher : le système doit pouvoir produire des éléments sans que je lui demande.
Par exemple : il signale une contradiction entre une intention nouvelle et une décision déjà prise, avant que j’agisse.
5. Garantir : le système doit être capable de certifier ce qu’il s’y passe, pour maintenir sa pertinence dans le temps.
Par exemple : deux fichiers qui se contredisent sont repérés sans que je fasse l’audit à la main.
Chaque pilier se décompose ensuite en 3 capacités, soit 15 au total (cf. détail dans le lien ci-dessous). Et chaque capacité peut obtenir 3 notes :
- 0 : je ne peux pas, ou je reconstruis tout à la main.
- 1 : j’y arrive, mais en indiquant les fichiers, en relançant, en recollant plusieurs sources.
- 2 : le système le fait seul de bout en bout, et je peux m’y fier.
Si cela vous intéresse, voici la grille détaillée, avec ses 15 capacités, et toutes les subtilités de l’évaluation. Collez-la dans votre système et demandez-lui de s’auto-évaluer, vous obtiendrez une note sur 30. Cette grille va également nous servir de point de départ pour notre tuto par la suite, pour construire le second brain.
Avec le recul, les quelques heures passées à construire cette grille sont le meilleur investissement de tout mon été, et je continue à l’utiliser pour m’améliorer.
5. Par où commencer, si vous voulez en construire un
Plusieurs ordres sont possibles, mais voici comment je m’y prendrais si je devais recommencer de zéro.
Ma recommandation est de ne pas utiliser de base de données, pas d’application qui stocke à votre place, pas de format propriétaire. Simplement des fichiers .md, lisibles par vous, par n’importe quel modèle, et par le prochain outil qui sortira. Le modèle (Claude ou autre), n’est qu’un moteur qu’on branche dessus : les règles, les instructions, les journaux, tout vit dans le dossier, au format texte et rien dans la mémoire de l’outil. (et ça vous sauvera beaucoup de soucis, je le sais, car j’ai supprimé toutes mes données Claude sans faire exprès en cours de process ; comme tout était en dur sur le disque, j’ai recréé mes projets et leurs mécaniques en 20 minutes)
Étape 0 — Utiliser Claude et se familiariser avec Cowork
Commencez par acheter un abonnement Claude, pour obtenir un accès à Cowork, et télécharger l’application desktop. Construisez a minima 2 projets Cowork, en local sur votre PC :
- un projet Cowork “ImproveClaude” qui aura un accès exhaustif à tous les espaces que vous souhaitez ouvrir à Claude, ainsi qu’à votre dossier “Documents\Claude”
- a minima un projet Perso ou Pro qui sera utilisé pour construire vos livrables et stocker vos idées, vous aider dans votre vie. Je vous recommande de créer un projet Cowork par grande thématique “étanche”.
Étape 1 — Créer un dossier Livrable qui contient les instructions de vos projets Cowork
Afin de rendre votre système conscient de ses propres fonctionnalités et capacités, les instructions de vos projets Cowork doivent être générées (et donc visibles) par votre projet Cowork “ImproveClaude”. Expliquez à ImproveClaude que vous souhaitez qu’il écrive vos instructions de projets Cowork, et prenez ensuite juste l’habitude de copier coller ces instructions qu’il remettra à jour dans vos projets dans l’application Claude. Cette étape est critique pour la construction de votre second brain, c’est ce qui fera la différence avec un agent qui répond juste correctement.
À partir d’ici toutes les étapes suivantes sont à exécuter dans votre projet Cowork ImproveClaude pour qu’il puisse les appliquer une première fois puis systématiser leur application dans le futur. Il se chargera également de vérifier leur cohérence entre elles, et de vous orienter dans les choix d’implémentations. Ne faites donc pas ces étapes vous-mêmes à la main !
Étape 2 — Séparer deux types de fichiers, et ne jamais les mélanger
D’un côté les fichiers “livrable” datés. Ils portent la trace de ce que vous pensez à un moment donné, et ce sont les livrables par défaut de vos échanges avec Claude. De l’autre, un fichier “thématique” par sujet : patrimoine.md, famille.md, investissement.md. Il porte l’état actuel, s’écrit au présent, et s’enrichit de manière incrémentale à partir de plusieurs fichiers datés. Expliquez à votre projet ImproveClaude cette distinction pour qu’il puisse mettre en place cette convention.
Étape 3 — Écrire chaque règle à un seul endroit
Commencez par créer un fichier de règles. Et la première règle est qu’une règle qui vaut pour plusieurs sujets vit dans un dossier commun, et chaque espace y renvoie au lieu de la recopier. Sinon les deux copies divergent, et c’est le début des problèmes. Par exemple : l’étape 2 est à appliquer partout, dans chacun de vos projets. Il est donc préférable de l’écrire une seule fois dans un fichier “convention_cowork.md” qui sera lu au démarrage de chacun des projets Cowork. Et ce sont les instructions du projet Cowork (générées par ImproveClaude) qui appeleront ce fichier et ancreront cette pratique.
Étape 4 — Donner une date de péremption à chaque fiche vivante
En place de la date de mise à jour des fichiers, ajoutez une seconde ligne : une date butoir, un événement attendu, ou une condition nommée qui indique que son contenu n’est plus valide. Puis créez une tâche transverse qui repasse et vérifie ces conditions afin de vérifier que le contenu de votre second brain reste toujours à jour. Sans elle, un second brain devient un cimetière très bien rangé, ce qui est exactement le piège dans lequel Forte voyait tomber ses propres lecteurs.
Étape 5 — Tenir un journal des décisions
Construire un fichier avec une ligne par décision avec la date, la justification, et ce qui a été écarté. Chez moi, j’ai construit un journal de décisions pour le pro, un pour le perso, un pour la construction du second brain lui-même, tous alimentés automatiquement par Claude. Leur intérêt n’est pas l’archive mais de me forcer à expliciter pourquoi j’ai tranché un certain point. Et avec le temps, ils apprennent au système comment je fonctionne : sa précision monte d’un cran sur tout le reste.
Étape 6 — Dire où l’agent a le droit d’écrire, là où il ne peut que proposer
Quand une information vient d’une source externe (le web, un forum, une synthèse écrite par un tiers), l’agent n’a pas le droit de modifier mes fichiers “thématiques”. Il n’a que le droit de proposer. Il écrit ses trouvailles dans un fichier de propositions daté (type “livrable”), et c’est moi qui décide de les reprendre. La nuance paraît mince mais elle change tout : elle permet d’ouvrir des automatisations qui sinon créeraient un immense foutoir dans mes fichiers les plus importants.
Étape 7 — Faire logger les tâches automatiques, dès la première
Créez un carnet de bord par tâche, où elle écrit ce qu’elle a fait. C’est ce qui permet de vérifier qu’elle tourne encore, et surtout qu’elle ne dérive pas. Ça m’a permis de rattraper des erreurs de lecture et d’écriture sur mes revues de backlog, que je n’aurais jamais vues autrement.
Étape 8 — Brancher les outils sur étagère, et seulement à la fin
Ajoutez un backlog (Trello, Notion, Airtable) pour que Claude lise et écrive les tâches entre deux sessions, avec les nouvelles entrées en statut « Proposition Claude » afin de ne pas polluer la liste. J’ai également ajouté un CRM, pour qu’il connaisse les gens que je mentionne et m’encourage à entretenir mon réseau. Ces modules existent sur étagère, ils sont gratuits ou presque, mais ils restent des gadgets tant que les sept étapes précédentes ne sont pas posées. Vous pourrez ensuite rajouter des modules et des connecteurs en fonction de vos besoins spécifiques.
Par quoi ne surtout pas commencer, donc : par l’outil. C’est l’erreur classique qui fait que la qualité du contenu produit et l’effort de maintenance deviennent plus lourds que la valeur générée. Et c’est aussi l’approche que vend la moitié des contenus sur le sujet.
6. Mon set up, et ce qu’il permet
Une fois que vous aurez fait tout ça, vous devriez atteindre une note du même ordre que la mienne : 20 sur 30 selon la grille précédente.
Concrètement, votre set up ressemblera à un ensemble de dossiers et de fichiers textes sur votre disque dur. Rien d’autre. Un peu comme Karpathy. De mon côté, ce sont 274 fichiers texte : 174 livrables datés, que je ne réécris jamais, et 100 fiches vivantes, qui portent l’état actuel d’un sujet. 80 d’entre elles ont une date de péremption et se remettent à jour toutes seules. Six projets Cowork les lisent et s’en servent de source, dix tâches programmées les entretiennent et les enrichissent.
Les principaux points d’amélioration sont “Capter” et “Déclencher”, qui nécessitent des connecteurs et des automatisations, ou qui sont simplement trop complexes. Par exemple : comment capter et logger simplement toutes mes conversations ?
Ce que ça donne concrètement, de bout en bout
Je mets un like sur X, sur un post qui parle de stratégie d’investissement. Je n’en fais rien d’autre, et je l’oublie dans la minute.
Quelques jours plus tard, j’ai une tâche qui fait une revue de mes likes récents. L’agent retrouve ce post, et identifie son sujet. Il fait le lien avec mes centres d’intérêt et va chercher d’autres informations pour mieux comprendre ce que l’auteur propose vraiment. Puis il confronte cette proposition à mes convictions et à mes idées d’investissement déjà écrites, relève les points d’écart, et va lire les décisions que j’ai prises avant sur le même terrain. Sa conclusion : au regard de ma thèse d’investissement, c’est une mauvaise idée, et ça ne vaut pas le coup de changer quoi que ce soit.
Le rendu utile de mon second brain, ce jour-là, aura été de me dire de ne rien faire, et de m’expliquer pourquoi.
Le même mécanisme, côté pro
Je reçois un mail client qui me demande un update sur une proposition commerciale. Mon second brain regarde dans mes mails les retours demandés, ouvre le bon dossier client, connaît mon avis et mes contraintes sur le sujet, et crée directement une nouvelle proposition commerciale mise à jour. Et pour les éléments incertains, il me fait des propositions. Après ma validation, il me draft ensuite une réponse, qui correspond à ma tonalité et à mon niveau de langage. Temps total, 5 min.
7. Et maintenant, on fait quoi de tout ça ?
Voilà où j’en suis après mes cent heures de cet été, avec un système qui m’aide à consolider beaucoup d’information, et à générer de manière rapide, efficace, fiable et semi-automatisée mes contenus pro et perso.
Clairement je n’ai pas un Jarvis dans mon casque qui anticipe tous mes besoins. Mais est-ce que pour autant on peut dire que j’ai construit un second brain ? A priori oui, au sens où je l’ai défini plus haut : c’est bien hors de ma tête, avec du contenu pertinent, mis à jour, relié, et une machine sait le retrouver sans moi.
Et si on me demandait aujourd’hui ce qu’est un second brain, je répondrais probablement que ça peut être à peu près tout et n’importe quoi, et que la technologie change sa composition très régulièrement. Ce qui ne bouge pas, ce sont les capacités qui doivent émerger de ce système. C’est bien pour ça que la grille tient encore : elle me sert à jauger les systèmes que je croise, à filtrer ce qu’ils proposent, et à garder ce qu’ils font mieux que le mien.
Mais maintenant le point clé : est-ce que réellement ce second brain me fait gagner du temps ? Ma grille permet simplement d’évaluer ce qu’il sait faire, pas s’il est utile. Et ce sont deux choses bien différentes.
Je suis convaincu que oui, mais c’est extrêmement difficile d’évaluer ce qu’un tel système permet de gagner. Et la seule évaluation rigoureuse des fichiers de contexte publiée à ce jour conclut même négativement : ETH Zurich et LogicStar, février 2026, 138 situations issues de 12 projets réels. « Providing context files does not generally improve task success rates, while increasing inference cost by over 20 % on average. » Donc je suis satisfait, mais reste assez humble sur mes réalisations et je continue à avancer.
Mais tout comme Bush, Luhmann et Forte, je ne vais pas tarder à me confronter à un nouveau mur technologique, et chaque point supplémentaire va me coûter de plus en plus cher. Eux ont buté sur le papier, sur le quart d’heure de réécriture, sur une routine plus lourde que la vie qu’elle devait servir.
Je ne sais pas encore sur quoi je vais buter, ni quand. Et la vraie difficulté sera de savoir m’arrêter avant.
Sources principales : Vannevar Bush, « As We May Think », The Atlantic, juillet 1945 · Niklas Luhmann, Zettelkasten, université de Bielefeld · Evernote, ouverture du service en 2008 · Tiago Forte, première session de « Building a Second Brain », janvier 2017, livre du même nom en 2022 · Roam Research, 2019 · Obsidian, 2020 · Andrej Karpathy, llm-wiki, 4 avril 2026 · ETH Zurich et LogicStar, arXiv:2602.11988, février 2026, révisé en juin.